El sábado 12 de septiembre publiqué en este blog por qué quiero dedicar mi vida a la seguridad de la IA. Ese mismo sábado, Dario Amodei publicó "We Must Pace the Frontier" (una locura el timing y la coincidencia). Básicamente, el CEO de Anthropic pedía, literalmente, bajar el ritmo al que mejoran las capacidades de los modelos. En cuestión de horas Sam Altman lo llamó una "gran idea", Demis Hassabis dijo que "the direction is correct" y Elon Musk se sumó al coro. Los cuatro tipos que más aceleran esta tecnología en el planeta, de repente estaban de acuerdo en que había que frenar todo... algo curioso no?
Dos días después, el presidente de Estados Unidos escribió que había una "SICK conspiracy" contra la IA y los data centers, y que el único contento con eso era China. Ese mismo lunes, la cancillería china calificó el pedido de los CEOs como "fearmongering, confrontation and vicious competition". Y diez días más tarde, Xi Jinping cenaba entre 'amigos' en la Casa Blanca rodeado de Jensen Huang, Tim Cook, Lisa Su, Sam Altman y Elon Musk. Amodei, el que había empezado todo, aparentemente no fue invitado, lo cual me parece algo super raro..
Mirá la secuencia completa. Los dos gobiernos dicen, cada uno con su vocabulario, que esta tecnología les da miedo y que hay que tener recaudos/precauciones, y mientras los líderes de la industria dicen lo mismo, el resultado de la cumbre fue un diálogo con nombre en disputa y un "canal de incidentes" del que nadie sabe qué incidentes va a transportar. Este post es mi intento de entender por qué, mezclando lo que pasó en Washington con un paper de 2016 que lo explica demasiado bien, quizás un poco simplista pero con mucho sentido común.
Entonces qué pasó realmente en Washington?
Primero los hechos, porque la cobertura fue algo confusa entre tanto hype. Xi hizo una visita de Estado del 23 al 25 de septiembre, con la reunión central y la cena el jueves 24. No hubo comunicado conjunto: cada gobierno publicó su propio resumen o 'readout'. Pero sobre IA, el saldo fue este:
- Un diálogo bilateral. La Casa Blanca lo bautizó "U.S.-China Super Intelligence (SI) Dialogue". Beijing lo llama "China-U.S. AI Dialogue". La próxima ronda quedó para el 18 al 19 de noviembre de 2026 en Shenzhen, China.
- Un canal de comunicación para incidentes relacionados con IA. Ni Washington ni Beijing publicaron reglas de operación, umbrales, métricas... ni siquiera qué cuenta como incidente como para hablar un idioma común.
- Nada sobre chips. Los export controls quedaron prácticamente fuera de la agenda pública, y el resumen de la cancillería china con los ocho entregables de la cumbre ni los menciona, es claramente un tema super sensible y troncal del avance Chino en IA.
Un analista citado por CNBC resumió los resultados como "all quite limited and tentative". CSIS fue algo más generoso: el diálogo de IA es la única área sustantiva de cooperación en gobernanza global entre los dos países, y su valor va a depender de cómo se implemente la operatoria real. Las dos lecturas son compatibles. Y a fines de octubre, según el South China Morning Post, los equipos siguen negociando los detalles del marco de cara a APEC en Shenzhen. Es decir, todavía es una declaración.
Para entender por qué salió tan poco, hay que mirar las tres semanas que rodearon la cena:
Trump en Beijing
Primera cumbre del año. Trump dice que hablaron de "possibly working together for guardrails" en IA, y que salieron los chips H200 de Nvidia. Nada concreto.
Xi abre la World AI Conference en Shanghai
Primer keynote de Xi en la conferencia. Posiciona a China como líder del open source y de una gobernanza global "equitativa", un día después de que 29 países firmaran la creación de la World Artificial Intelligence Cooperation Organization con sede en Shanghai.
Anthropic publica su reporte de amenazas
En su sección final acusa a Moonshot AI de haber reenviado en silencio pedidos de usuarios de Kimi a Claude y de haberles servido las respuestas como si fueran de Kimi (gran problema para China).
We Must Pace the Frontier
Amodei pide bajar el ritmo de mejora de capacidades. Altman, Hassabis y Musk lo respaldan con matices (Bum! El mundo de repente habla de AI Safety).
El Ministerio de Seguridad del Estado chino advierte sobre la IA
El ministro Chen Yixin publica un artículo firmado sobre seis categorías de riesgo, con la seguridad política a la cabeza.
Trump y Beijing rechazan frenar
Trump habla de una "SICK conspiracy". La cancillería china habla de "fearmongering". Coinciden en algo, aunque no sea lo que uno esperaría...
Cumbre y cena de Estado en la Casa Blanca
Diálogo bilateral sobre IA y canal para incidentes. Sin reglas publicadas, sin comunicado conjunto.
APEC en Shenzhen y segunda ronda del diálogo
La próxima prueba real... si el canal de incidentes llega a noviembre sin definiciones o pasos claros, sería un gran problema para una cooperación real.
Dos vocabularios para el mismo miedo
El detalle más revelador de la cumbre fue lingüístico. La mañana del jueves, Trump posteó: "Super Intelligence (SI) will be a big topic of discussion, but I want to leave it exactly where it is. That is China's position also." Washington ya venía usando "Super Intelligence" en lugar de "artificial intelligence" en documentos oficiales y el Departamento de Estado instruyó a sus diplomáticos a usarlo (fue un meme en la comunidad cuando también asoció a los investigadores del campo con IQ's altos). Después de la reunión, Trump dijo que a Xi "seemed to like" el nombre nuevo.
Xi no usó el término ni una vez. Habló de que los dos países tienen la capacidad y la responsabilidad de desarrollar la IA "para el bien" y de mantener su desarrollo bajo control humano. Su readout dijo que en IA pueden competir pero cooperar todavía más.
Parece un dato anecdótico o innecesario pero el significado de las palabras tiene un peso, y en este contexto aún más. Si no se pueden poner de acuerdo en definir que es que, siendo lo más simple de definir entre toda la complejidad del asunto, parecería ser aún más difícil de encontrar acuerdos a cuestiones más urgentes.
Y devuelta, parece un chiste que lo traiga, pero no lo es. El vocabulario dice qué riesgo considera central cada lado.
Del lado chino, el texto más claro no salió de la cumbre sino del artículo de Chen Yixin, ministro de Seguridad del Estado, publicado el 13 de septiembre. Ahí escribe que el uso abusivo de la IA por parte de adversarios podría "directly threaten China's political security, institutional security and ideological security". Las seis categorías de riesgo que enumera arrancan por la seguridad política y siguen con ciberataques más sofisticados, robo masivo de información sensible, monopolios tecnológicos, disrupción de la gobernanza social y cambios en la guerra moderna. Y, como señaló Crypto Briefing, en ningún momento sugiere que China deba frenar su propio desarrollo.
En la entrevista de DW que me disparó parte de este post, la analista Rebecca Arcesati lo dice sin vueltas: para un Estado de partido único intensamente preocupado por su control del poder, el riesgo número uno no es el existencial, es que fuerzas extranjeras usen la IA para manipular la opinión pública y desestabilizar al régimen. Las regulaciones chinas de IA (sistemas de recomendación, IA generativa) nacieron del control de la información, y recién ahora se están ampliando hacia riesgos de frontera.
Why Beijing fears AI could be used as a weapon against its regime | DW News
Entrevista de DW News sobre la advertencia del Ministerio de Seguridad del Estado chino, el caso WeChat, la acusación de Anthropic contra Moonshot y por qué nadie espera un avance en seguridad de IA entre Washington y Beijing.
Dos casos que hicieron la pesadilla concreta
Septiembre le dio a Beijing dos ejemplos que, mirados con ojos de seguridad, explican mejor que cualquier comunicado por qué su miedo es político y técnico a la vez.
WeWorm. La firma estadounidense Calif publicó un proof of concept de un worm que tomaba control de cuentas de WeChat con una sola llamada que la víctima nunca atendía: una corrupción de memoria en el manejo de llamadas VoIP, zero-click, con el requisito de que el atacante ya estuviera en la lista de contactos. Comprometida una cuenta, el worm podía saltar a los contactos de esa cuenta. Según Calif, encontraron el bug en julio con asistencia de IA, lo reportaron a Tencent y el fix server-side llegó a fines de agosto. Tencent dice que no hay evidencia de explotación in the wild, y no publicó advisory ni CVE. La cobertura se apoya casi entera en el relato de Calif, así que lo tomo con "pinzas" ya que no hay mucho más que eso.
Ahora pensalo desde Beijing. WeChat es mensajería, pagos e identidad para más de mil millones de personas, y además es infraestructura de vigilancia del propio Estado. Que una empresa estadounidense, con IA, encuentre una cadena zero-click y wormable sobre esa superficie es exactamente el escenario que describe Chen Yixin.
Además, otro suceso curioso que pasó no hace mucho fue que Kimi que en realidad era Claude. El reporte de amenazas de Anthropic de septiembre cierra con una acusación contra Moonshot AI. Donde según Anthropic, la empresa "silently forwarded customer requests to Claude, instead of processing them using Kimi". Es decir, usuarios que creían usar el modelo chino recibían respuestas de Claude. Anthropic atribuye a a la empresa más de 23 millones de intercambios entre mayo y julio, y describe una técnica para recuperar reasoning traces reabriendo sesiones con firmas de thinking guardadas. Obviamente Moonshot no respondió a la acusación pero como decimos en mi país, "el que calla otorga". Igualmente también vale la reserva obvia, la evidencia es telemetría de Anthropic, y Anthropic no es un actor neutral en esta carrera y si queremos mantenernos en objetividad es algo de un lado hacia otro sin empresas "neutrales" constatando un punto o el otro.
La lectura de seguridad
Los dos casos son, en el fondo, problemas de supply chain y de integridad. En uno, la confianza en una plataforma nacional se rompe por un bug que una IA ayuda a encontrar. En el otro, la promesa de soberanía tecnológica de los modelos abiertos chinos se rompe porque, al menos según la acusación, parte del producto era un proxy a un modelo estadounidense. Ninguno de los dos es un problema que se resuelva con una cumbre, pero los dos son exactamente el tipo de evento para el que un canal de incidentes debería servir.
La otra carrera: inteligencia por dólar
Hay un segundo plano que la cumbre ni tocó y que para mí es el más importante en el corto plazo. Ya lo desarmé en detalle en el post sobre la brecha de costos entre EE.UU. y China, así que acá voy a lo esencial.
En el video "Cómo planea China ganar la carrera global de la IA" hay una frase que resume todo: "You don't need god to write your emails". No necesitás el modelo más inteligente del mundo para el 90% de lo que hacés con IA. Estados Unidos está jugando la carrera de la frontera, la del modelo más capaz. China está jugando, mucho más agresivamente, la del ratio inteligencia/costo, con modelos de pesos abiertos. En el video aparece un emprendedor que pagaba unas diez veces menos al pasarse a modelos chinos, y los datos de OpenRouter van en la misma línea: según el relevamiento de CNBC, la porción de tokens que organizaciones estadounidenses mandan a modelos chinos llegó a un pico semanal del 46% a mediados de 2026, contra 4,5% en la primera mitad de 2025.
Energía barata, más talento, más escala (son 1300 millones de habitantes) y más pesos abiertos lo que para mí da una receta letal. La monetización directa es difícil, pero sospecho que no es el objetivo del gobierno CHino. El objetivo, al menos en mi opinión, es meter la tecnología en la infraestructura de medio mundo, más barata y suficientemente inteligente, con una fracción de la inversión estadounidense. EE.UU. sigue teniendo más cómputo, mejores chips y una valuación de mercado enorme, y eso le da una ventaja real en la frontera. Pero son dos carreras distintas corriendo al mismo tiempo, y eso importa para lo que viene, porque en las dos el incentivo es el mismo: ir más rápido.
La matemática del precipicio
En 2016, Stuart Armstrong, Nick Bostrom y Carl Shulman publicaron "Racing to the Precipice: a Model of Artificial Intelligence Development". Leerlo después de la cumbre es incómodo, porque describe septiembre de 2026 con nueve años de anticipación.
El modelo es simple a propósito. Hay n equipos desarrollando IA. Cada uno tiene una capacidad (cuánto avanza) y elige un nivel de seguridad s entre 0 (negligencia total) y 1 (máxima precaución). Más seguridad significa ir más lento. El primero que llega a la IA "gana" y aplica su nivel de seguridad: si fue bajo, la probabilidad de desastre es alta, y el desastre es para todos.
El núcleo es un equilibrio de Nash. Si un equipo recorta su seguridad en una cantidad pequeña para ganar velocidad, obtiene una ventaja competitiva inmediata y asume un riesgo catastrófico mayor solo en el caso de ganar. Si los demás razonan igual, todos recortan. Nadie elige el precipicio, todos llegan ahí por pasos individualmente razonables.
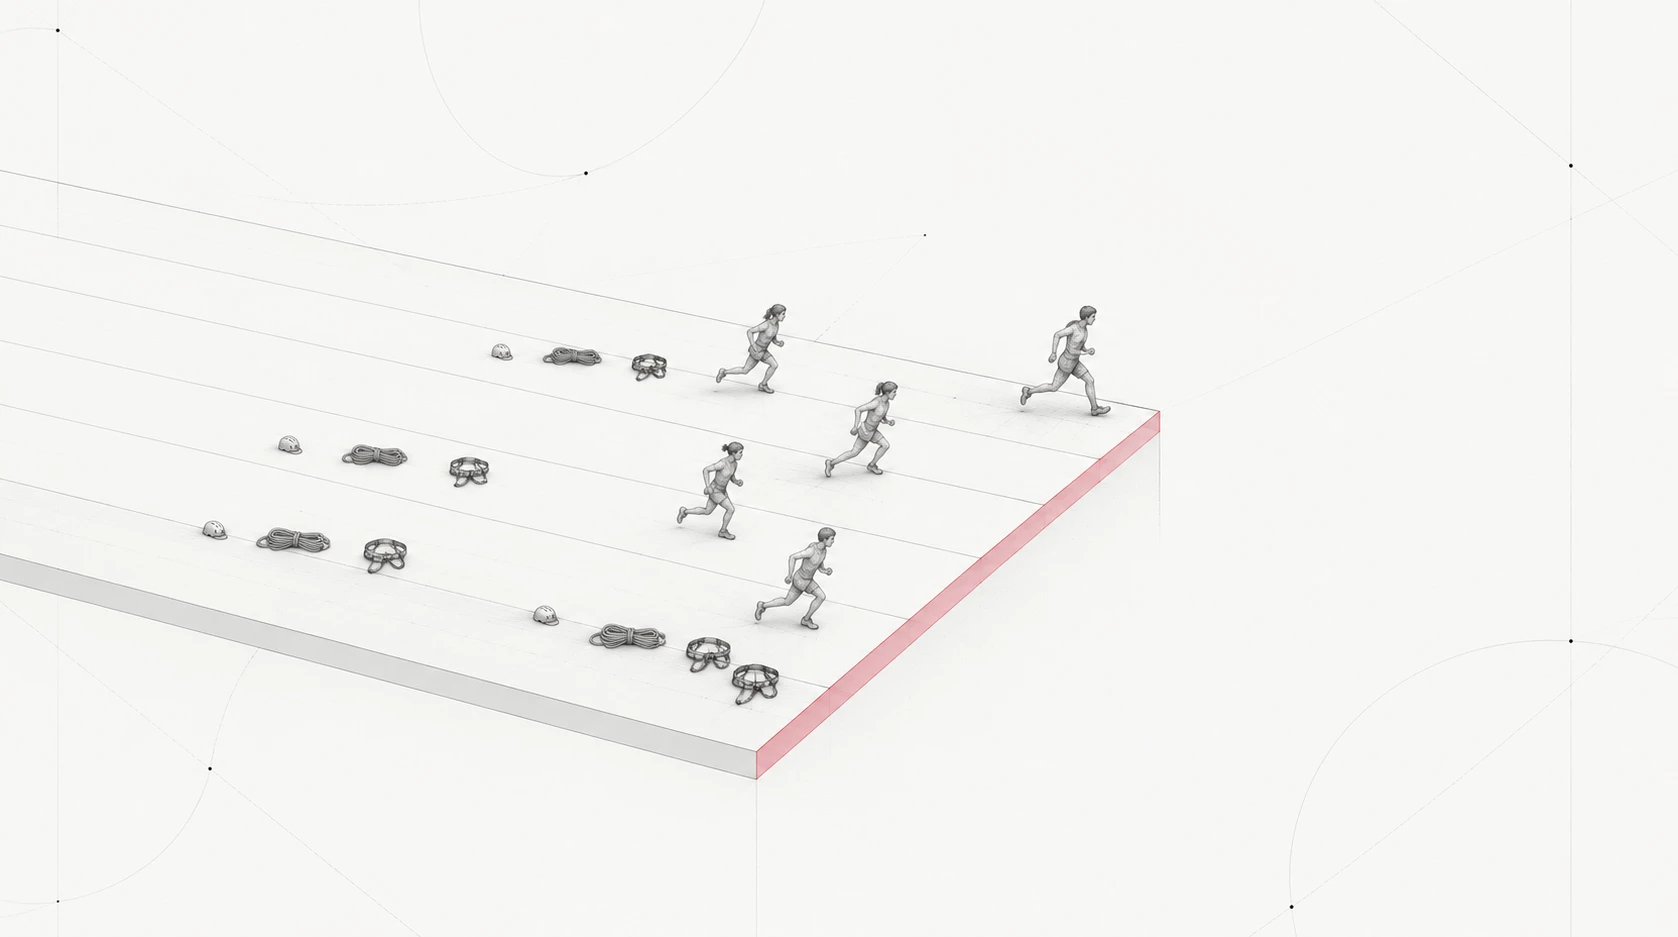
El paper identifica cuatro factores que mueven el riesgo. Tres son intuitivos y uno no tanto...
| Factor del modelo | Qué reduce el riesgo | Dónde estamos en 2026 |
|---|---|---|
| Peso de la capacidad vs. la seguridad | Que la capacidad importe mucho más que lo que se gana recortando seguridad | Las ventajas son de meses y se compran con velocidad, así que recortar paga |
| Enemistad entre equipos | Menos enemistad, más disposición a ir despacio | Acusaciones de destilación, de psyops y de "fearmongering" cruzadas entre los dos gobiernos |
| Número de equipos | Menos equipos (en la mayoría de los casos) | Varios labs de frontera en EE.UU., varios en China, y pesos abiertos que multiplican los competidores |
| Información disponible | Contraintuitivo: saber menos sobre las capacidades propias y ajenas reduce el riesgo | Benchmarks públicos, leaderboards semanales y destilación: todos saben casi todo de todos |
El paper modela tres escenarios de información: sin información, información privada (cada equipo conoce solo su capacidad) e información pública (todos conocen la de todos). El resultado contraintuitivo es que más información aumenta el riesgo: si sabés que estás apenas adelante o apenas atrás, tenés todos los incentivos para recortar. Los autores lo llaman un caso particular de information hazard: estaríamos mejor sin saber en definitiva.
Armstrong, Bostrom y Shulman (2016)"When competition gets less fierce, teams would be willing to take less risks."
Estoy cien por ciento de acuerdo con esa frase, y es muy de naturaleza humana. Lo que me cuesta es el paso siguiente. La enemistad es la variable que en teoría se puede trabajar: construyendo confianza entre organizaciones y Estados, compartiendo tecnología y hallazgos. Askell, Brundage y Hadfield lo formalizaron en 2019 para la cooperación entre empresas: la cooperación es más probable con alta confianza, beneficios compartidos, baja exposición, baja ventaja de quien no coopera y pérdidas compartidas si las cosas salen mal.
Me parece ingenuo esperar eso entre un Estado que está perdiendo su hegemonía global y justamente el Estado que la amenaza. Si pongo los cuatro factores de Bostrom sobre la mesa de septiembre, estamos en el peor cuadrante posible: competencia feroz, tanto dentro de EE.UU. como entre países, sin incentivos reales de cooperación ni entre los labs ni entre los gobiernos, y con muchísimo conocimiento de lo que hace el competidor. El equilibrio de Nash nos da su peor versión.
Porque me parece que nadie va a frenar
La tesis central de la entrevista de DW es un dilema del prisionero: los labs estadounidenses tienen incentivos para parecer serios en seguridad (reputación, confianza), pero ninguno va a pausar unilateralmente porque nadie confía en que los competidores, ni China, hagan lo mismo. Septiembre lo mostró en vivo:
- Los labs piden coordinarse y no pueden. No está claro si los reguladores antimonopolio permitirían que las empresas acuerden un ritmo común. Altman dijo que OpenAI no necesitaba esperar una ley ni una exención antitrust para actuar sobre seguridad, lo cual es cierto y a la vez esquiva la pregunta: un lab que frena solo le regala el mercado al resto.
- El gobierno de EE.UU. lo lee como amenaza. Trump dijo que EE.UU. está "about a year, maybe a year and a half up on China" y que regular abriría la puerta a Beijing. Mike Johnson rechazó una moratoria porque "we will lose our edge to China" (y ese edge se reduce mes a mes según las estimaciones de expertos más conservadoras).
- Beijing lo lee como maniobra. Para la cancillería china, el pedido de frenar es "fearmongering". SemiAnalysis lo tituló sin vueltas: Beijing no va a "pace the frontier".
- La desconfianza contamina hasta el debate interno. Tech Policy Press documenta cómo en EE.UU. a los críticos del desarrollo acelerado se los acusa de ser psyops pagadas por China. Cuando cualquier pedido de cautela se interpreta como operación del adversario, la cautela se vuelve políticamente imposible y el hype con desconfianza se meten por todas las conversaciones y en diferentes ámbitos.
Hay un intento serio de pensar estabilidad dentro de esta competencia: la propuesta de Superintelligence Strategy de Hendrycks, Schmidt y Wang, con su concepto de Mutual Assured AI Malfunction (MAIM), una disuasión al estilo nuclear. RAND la analizó y, aunque considera razonables muchas de sus recomendaciones, su reserva principal es justamente la analogía: la IA no se parece a las armas nucleares ni en la tecnología ni en el ecosistema, y eso tiene implicancias estratégicas profundas. La disuasión nuclear funcionó en parte porque las ojivas se pueden contar. Los avances en IA no y el alcance es global y en todos los sectores e industrias.
No creo que el pedido de los CEOs estadounidenses de bajar el ritmo vaya a traducirse en una acción real. No porque no sean sinceros, sino porque el equilibrio no se lo permite. Al final del día, siempre todo se resume a los "incentivos" de todas las diferentes partes.
Qué tendría que tener el canal de incidentes
Hasta acá el diagnóstico es bastante oscuro, y no lo quiero maquillar. Pero hay una cosa concreta que salió de Washington y que conozco bien desde mi laburo: un canal para incidentes, la típica línea directa. En ciberseguridad tenemos décadas de experiencia con esto (CERTs nacionales, coordinated vulnerability disclosure, acuerdos de notificación entre Estados), y lo que aprendimos es que un canal sin definiciones es un número de teléfono que nadie atiende.
Hay además un detalle que me parece elegante. El paper de Bostrom dice que compartir información sobre capacidades aumenta el riesgo. Pero compartir información sobre incidentes es otra cosa: no le dice al otro cuán cerca estás de ganar, le dice dónde se rompió algo. Es una de las pocas formas de transparencia que no alimenta esa carrera, al menos según esa hipótesis.
Para que no quede en foto, yo miraría esto en la ronda de noviembre:
- 1
Una taxonomía de incidentes
Qué se notifica y qué no. Por ejemplo: pérdida de control de un agente autónomo con efectos fuera del entorno previsto, uso de modelos en operaciones contra infraestructura crítica, robo de pesos de modelos de frontera, exfiltración de capacidades por destilación a escala. Sin taxonomía, cada lado decide caso por caso, y eso significa que no notifica nada incómodo.
- 2
Umbrales y plazos
Igual que en cualquier régimen de notificación de brechas: a partir de qué severidad se notifica y en cuántas horas. Un canal que se usa semanas después del incidente sirve para la historia, no para la contención.
- 3
Contrapartes técnicas, no solo diplomáticas
Los equipos que negociaron la cumbre vienen de Tesoro y Comercio, no de seguridad de IA. Un canal útil necesita del otro lado gente que pueda leer un reporte técnico y actuar, al estilo de un CERT, no solo un despacho que reenvía cables a alto nivel.
- 4
Un primer uso de bajo riesgo
La confianza se construye con repetición. Algo como WeWorm (una vulnerabilidad ya parcheada, en una plataforma civil, descubierta con IA) sería el tipo de caso ideal para estrenar el canal: útil para los dos, sin revelar capacidades de frontera de ninguno.
Nada de esto frena la carrera. Lo que hace, si funciona, es bajar un poco la enemistad, que de las cuatro variables del modelo es la única que se puede mover con diplomacia. Es poco. Pero es más de lo que había en agosto.
Referencias
Si te interesa seguir profundizando, estos son los materiales que más me sirvieron para meterme más en esta mini subcategoría dentro de AI Safety:
- Armstrong, Bostrom y Shulman - Racing to the Precipice (2016) - El modelo de carrera, el equilibrio de Nash y el resultado contraintuitivo sobre la información.
- Askell, Brundage y Hadfield - The Role of Cooperation in Responsible AI Development (2019) - Los cinco factores que hacen más probable la cooperación entre desarrolladores.
- RAND - Seeking Stability in the Competition for AI Advantage - La crítica a MAIM y a la analogía nuclear.
- Tech Policy Press - US-China psyop accusations signal deep distrust on AI regulation - Cómo la desconfianza geopolítica contamina el debate regulatorio interno.
- Transformer - Bargaining with China: the US needs to regulate AI - El argumento de que la regulación doméstica es condición para negociar afuera.
- Axios - U.S. and China agree to "super intelligence" dialogue - Lo que se acordó en Washington y lo que quedó sin definir.
- CSIS - Takeaways from the Trump-Xi White House Summit - La lectura del diálogo como única cooperación sustantiva en gobernanza global.
- Anthropic - Countering misuse of AI: September 2026 - El reporte con la acusación contra Moonshot.
- SemiAnalysis - Beijing Will Not Pace the Frontier - El régimen de seguridad de IA chino, pensado para la velocidad.
- DW News - Why Beijing fears AI could be used as a weapon against its regime - La entrevista con Rebecca Arcesati sobre el miedo político de Beijing.
Cierre: el problema no es de información, es de confianza
Si tuviera que quedarme con una sola idea de todo esto, sería que la cumbre de Washington no fracasó por falta de conocimiento. Los dos gobiernos entienden los riesgos (Chen Yixin los enumera mejor que muchos papers occidentales) y los líderes de la industria también. Creo que falló porque el modelo de Bostrom se terminó cumpliendo: "con competencia feroz, enemistad alta, muchos equipos y todos mirándose los benchmarks, el equilibrio empuja a recortar seguridad aunque todos prefieran que nadie lo haga".
Soy pesimista sobre la cooperación profunda en el corto plazo (aunque no hay nada que desee más que tener un mundo unido donde el objetivo final sea el beneficio de la raza humana en su totalidad). Ese nivel de cooperación requiere dejar atrás lo peor de nosotros en términos de cultura y valores: el miedo a lo desconocido, a lo externo, la necesidad de ganar. No veo eso cerca. Pero un canal de incidentes con definiciones reales es algo chico, verificable y que no depende de que nadie confíe en nadie para empezar a funcionar. Desde la seguridad, es el tipo de control que sabemos construir.
Noviembre, en Shenzhen, vamos a saber si era un control o una foto. Crucemos dedos y estemos atentos!
Comprobá lo aprendido (opcional)
Poné a Prueba tu Conocimiento Tecnico
¿Qué acordaron Estados Unidos y China sobre IA en la cumbre de Washington del 24 de septiembre de 2026?
Según el artículo de Chen Yixin y el análisis de Rebecca Arcesati, ¿cuál es la preocupación principal de Beijing respecto a la IA?
En el modelo de Armstrong, Bostrom y Shulman, ¿qué efecto tiene que todos los equipos conozcan las capacidades de los demás, y por qué un canal de incidentes no cae necesariamente en ese problema?